從注音、拼音到 AI 語音輸入:我自己改了 UTUVO Type,最後還是付錢買 Typeless
我最近花了很多時間研究 AI 語音輸入工具。從 MacWhisper、Whisper、Groq、各種開源語音輸入專案,到自己串接 API、修改 Prompt,甚至直接參與 UTUVO Type 的開發,嘗試把 iOS 的 BYOK 語音輸入流程做到更可靠。
原本的目的很簡單:我想找一個比 Typeless 更便宜、可以自己控制模型,而且在 macOS 和 iOS 都能使用的方案。
畢竟 Typeless Pro 月繳要 US$30。以現在的 AI 開發能力,Whisper 已經有不錯的辨識效果,後面再串接一個 LLM 做文字潤飾,理論上應該不難做到類似的產品。更何況我本身就有工程背景,現在又有 AI Agent 協助開發,自己做一個似乎更符合成本效益。
但我研究、比較、實際測試,甚至修改原始碼之後,最後還是決定付費訂閱 Typeless。
這個結果對我來說蠻有趣的。因為我原本就是想省錢才開始研究替代方案,最後卻發現,一個工具的價值不能只看 API 成本,而要看它究竟消除了多少工作流程中的摩擦。
而且我對輸入法這件事情的執著,其實遠遠早於 LLM 的出現。
一、我為什麼一直這麼在意輸入法?
從很早以前,我就一直在研究如何讓自己更有效率地使用電腦。對我來說,生產力並不是單純追求每分鐘做更多事情,而是盡可能減少完成一個目標過程中,不必要的時間消耗和認知負擔。
輸入法就是其中一個我研究很久的題目。
早年我使用注音輸入法,後來開始研究輸入法引擎、選字演算法以及不同的輸入方式。我發現自己使用的注音輸入法在候選字選擇、組字與輸入流程上,總有一些讓我覺得不夠有效率的地方。於是我改用拼音輸入法,希望能夠減少選字、重新組字等操作。
這不代表拼音在客觀上一定比注音快,而是在我自己的使用習慣下,拼音輸入法的整體效率比較符合需求。
可是使用一段時間後,我又發現,不論使用哪一種輸入法,最終還是得透過鍵盤,一個字、一個字地將想法輸入電腦。即使鍵盤速度再快,人類透過手指輸入文字的速度仍然有物理上的限制。
所以後來我開始研究語音輸入。
這一路上,從注音、拼音,到語音辨識,我想解決的其實一直都是同一個問題:如何縮短從「腦袋產生想法」到「想法被完整表達」之間的距離?
尤其現在身為一個創業者、公司的 CEO,我對這件事情的感受又更加深刻。
CEO 大部分的工作,本質上都離不開人與人的互動。你需要跟團隊討論產品、跟工程師溝通需求、跟投資人解釋策略、跟客戶確認合作細節,也需要不斷透過文字、簡報、Email 和會議來傳遞自己的想法。
換句話說,很多時候我的工作成果並不是直接產出某一段程式碼,而是透過溝通,讓其他人能夠理解問題、做出判斷,並且採取行動。
在這種工作模式下,輸出能力就是很重要的生產力槓桿。
如果我花了十分鐘思考一件事情,卻還要花另外十分鐘把它打成文字,甚至再花五分鐘重新整理句子,那麼整個流程其實有非常多可以最佳化的空間。
不只是速度,還包含上下文切換、認知負擔和注意力消耗。當你正在思考複雜問題時,還得一邊顧慮選字、標點、句型和段落,這些動作都有可能打斷原本的思考。
所以我一直在追求一件事:讓輸入工具盡可能不打斷思考,最好能讓表達直接跟上思考的速度。
而 LLM 的出現,讓這個目標第一次變得非常接近現實。
二、LLM 改變的不只是工作能力,也改變了人類的輸入方式
過去我們討論 LLM 提升生產力,經常聚焦在 AI 能幫我們完成什麼工作,例如寫程式、做研究、分析資料、整理文件,或是讓 AI Agent 自動執行原本需要人工操作的流程。
但我認為還有一個很容易被忽略的瓶頸,就是人類把意圖傳遞給 AI 的速度。
現在的模型已經可以理解非常複雜的需求,處理大量上下文,甚至直接執行多階段任務。可是人類跟模型溝通時,還是經常得先把想法整理成文字。
這其實有點矛盾。我們花了大量資源提高模型的推理能力與執行能力,卻仍然用相對低效率的方式,把需求輸入給它。
語音輸入原本就可以解決一部分問題,但傳統 Speech-to-Text(STT)主要在做的事情,是盡可能忠實地辨識使用者說出的每一個字。
問題是,人類說話並不像寫文章。
我們經常會講到一半才發現前面的意思不夠完整,接著補充;有時候會說錯數字或日期,然後自己修正;有時候還會重複好幾次同樣的意思,只是為了讓自己想清楚。
例如我可能會這樣說:
我覺得這個產品的方向其實是對的啦,但我覺得現在我們開發的速度太慢了,因為現在很多競爭對手都已經開始在做 AI Agent 了,然後我們還在做一些基礎功能,所以我覺得這個部分可能要重新調整一下。可是也不是說我們要把現在的產品全部放棄,而是應該重新分配資源。
傳統語音辨識很可能只是把這段話完整轉錄下來,再加上一些標點符號。
但理想中的 AI 輸入法,應該直接幫我整理成:
我覺得目前的產品方向大致正確,但開發速度太慢了。許多競爭對手已經開始投入 AI Agent,我們卻還在處理基礎功能。
接下來可能需要重新分配開發資源,但不代表要完全放棄現有產品。
兩者的意思基本相同,但第二段文字更容易閱讀,也更適合直接拿去跟團隊討論。
這就是我認為 AI 語音輸入最有價值的突破。
過去的輸入法是在最佳化「如何更快輸入文字」;現在的 AI 輸入法,開始最佳化「如何更快把想法變成可以使用的表達」。
它不只是 Speech-to-Text,而是 Speech-to-Intent-to-Text。
這個差異非常大。因為如果一段文字在語音輸入完成後,還需要人工重新整理,那麼我們只是把原本打字的時間,轉移到編輯和校稿上。
真正重要的不是輸入速度有多快,而是整個流程從開始表達,到最後可以直接使用,究竟花了多少時間。
用工程的方式思考,我更在乎的指標其實是:
Total Time to Usable Text = 語音輸入時間 + 模型處理時間 + 人工修正時間 + 操作與切換成本。
即使某個語音模型的辨識速度非常快,只要後續需要大量修改,整體生產力仍然可能輸給一個處理速度稍慢、但輸出幾乎不需要修改的工具。
Typeless 真正讓我驚訝的,就是它在這個指標上做得非常好。
三、為什麼我覺得 Typeless 特別厲害?
第一次使用 Typeless 時,我其實沒有期待它會跟其他語音輸入工具有多大的差別。畢竟現在語音辨識模型已經很成熟,我原本以為各家的辨識準確率應該不會差太多。
但實際使用之後,我發現差異不只是準確率。
最明顯的感受是,Typeless 輸出的文字非常「直接可用」。
我不需要刻意放慢說話速度,不需要先想好完整句型,也不需要像過去使用語音輸入時,特別注意標點符號該怎麼處理。即使中間出現停頓、重複、臨時改口,最後的輸出通常還是相當自然。
而且它不會只是機械式地刪除口語贅詞。
它似乎能理解我整段話想表達的意思,重新安排句子、補上合理的標點,甚至在必要時調整語序,讓內容更符合一般人閱讀文字的習慣。
這件事情很難單純用 ASR 的 Word Error Rate(WER)來衡量。
因為 WER 主要比較語音辨識結果跟參考逐字稿之間有多少字詞錯誤。但如果產品的目標本來就不是完整逐字記錄,而是直接產生整理過的文字,那麼它還必須考慮語意保真、可讀性、專有名詞正確率,以及最後需要多少人工修改。
我自己特別在意這個問題,因為我經常口述一些包含大量專業名詞的內容,例如 Web3、VASP、KYB、Fireblocks、Hyperliquid,或是涉及公司營運、融資與產品策略的討論。
這些內容只要某個英文縮寫或數字出錯,就可能讓整段話的意思改變。
Typeless 另一個做得不錯的地方,就是它有個人字典和個人化功能。它可以根據使用者的修正逐步學習專有詞彙,也能適應不同情境下的寫作風格。官方也說明它會利用目前 App 類型和有限的相關上下文,改善文字輸出。
這代表它不只需要知道我「說了什麼」,還需要判斷我「現在打算把這段話用在哪裡」。
另外,我自己使用時還有一個感受:停頓的位置、說話時的強調方式,似乎也會影響它最終如何組織文字。
我甚至懷疑它可能利用了比一般逐字稿更豐富的音訊資訊,而不只是單純把 ASR 輸出丟給 LLM。
不過這裡必須區分觀察與事實。現代 ASR 本來就會直接處理音訊訊號,標點、停頓與語句邊界也可能透過其他機制推斷。目前沒有公開證據可以確認 Typeless 是否額外使用獨立的聲學韻律模型,或直接把原始音訊交給多模態 LLM 進行最後的文字生成。
但從使用者的角度來看,我確實感受到它對整段口述內容的處理,比我自己串接的幾種方案更加成熟。
再加上它的處理速度、快捷鍵、跨 App 輸入、背景運作和 iOS 整合,整體體驗真的相當出色。
這也是為什麼我開始好奇:如果這些功能看起來都能透過現有模型做到,為什麼開源替代方案還是很難達到同樣的表現?
四、我真的下去改了 UTUVO Type,才知道問題在哪裡
我不是只看了一些 GitHub Repository,然後就認為自己已經了解這個問題。
為了找到更便宜、可以自行控制模型的方案,我實際研究了 BYOK 的實作方式,也直接參與了 UTUVO Type 的開發。
我提交的 Pull Request #1:fix(ios): make BYOK dictation reliable 已經合併。
這個 PR 的目的,就是讓 iOS 上的 BYOK 語音輸入流程更加可靠。
原本遇到的問題其實很典型。語音已經成功辨識,LLM 也可能正確完成潤稿,但使用者最後收到的文字卻不一定是那個正確結果。
例如,系統可能先把原始逐字稿輸入到文字框,等到 LLM 潤飾完成,才試圖替換原本的內容。但在等待的過程中,如果游標位置或目前輸入欄位已經改變,就可能導致後續替換失敗。
又或者,LLM 原本成功把錯誤的專有名詞修正成字典中的正確拼寫,卻被系統自己的語意保真驗證規則誤判為不合法的修改,最後反而沒有採用正確結果。
甚至像「我昨天要四點,不對,三點出發」這種人類非常容易理解的自我修正,也可能因為系統偵測到數字被刪除,就認為模型改變了事實。
這些都不是單純更換一個更強大的 LLM 就能解決的事情。
所以我在 PR 裡面處理了幾個問題,包括讓潤稿完成後才一次性輸入文字、區分模型成功與文字實際送達、改善個人字典與專有名詞處理,以及讓驗證機制能夠接受明確的自我修正,同時繼續保護重要的數字與否定詞。
另外也調整了 iOS 的本機與雲端處理路徑,讓使用者可以選擇自己偏好的 ASR 和文字模型,並在服務失敗時盡可能利用本機辨識結果作為備援。
這個 PR 包含不少自動化測試,但部分真實裝置情境仍需要進一步驗證,並不代表所有 iPhone 背景錄音問題都已完全解決。
這次實作讓我更深刻理解一件事情:模型成功,不等於產品成功;模型輸出的文字正確,也不代表使用者最後真的拿到了正確的文字。
而且這還只是整個語音輸入 Pipeline 的其中一小部分。
第一個坑:Whisper 很強,但 ASR 仍然可能是錯誤的起點
在語音辨識這一層,我研究了 Whisper-large-v3-turbo 等模型,也嘗試不同的 API 組合。
Whisper 的確是一個非常優秀的模型。它能利用音訊與語言上下文進行辨識,對多語言、不同口音,以及一些比較複雜的語音情境都有不錯的表現。
但它並不是完全理解人類想表達的所有意思。
尤其對台灣繁體中文、中英混用,以及大量專有名詞的內容,仍然可能產生錯誤。Whisper-large-v3-turbo 為了提高推論速度,也將解碼器層數從原本的 32 層減少至 4 層,因此速度與辨識品質之間存在取捨。
舉例來說,如果我講的是某個 Web3 產品名稱,但 ASR 一開始就將它辨識成音近的普通中文字,後面的 LLM 未必有足夠資訊還原原本的內容。
這時候,不管你後面用多好的 Prompt,都可能只是把錯誤的文字修飾得更自然。
第二個坑:LLM 會把錯誤潤飾得更像正確答案
這個問題我覺得更危險。
如果把 ASR 產生的逐字稿直接送到 Groq API 上的模型,要求它移除贅詞、修正標點、改善語序,模型通常可以輸出一段非常通順的文字。
但通順不代表正確。
尤其當前面的 ASR 已經將某個名詞辨識錯誤,LLM 可能會根據錯誤的上下文,推論出另一個看起來更合理、但實際上完全不同的意思。
還有一種狀況是,模型為了改善可讀性,直接刪除它認為不重要的語句。偏偏那些語句可能包含否定、條件、時間、保留意見或不確定性。
例如「這個方案可能可以在明年第一季上線」,跟「這個方案明年第一季可以上線」,看起來只差幾個字,意思卻不一樣。
對一般聊天來說,或許還可以容忍。但如果是投資人溝通、產品規格或法遵文件,這種偏差就不能接受。
因此,一個成熟的語音輸入產品不能只有 ASR 和 LLM,還需要針對數字、專有名詞、否定詞、日期與語意強度建立驗證機制。
第三個坑:過度保守的 Prompt,反而讓文字很難讀
這是我自己反覆調整最多的地方。
我一開始使用的 Prompt,是把 LLM 定位成「ASR Transcript 最小修正器」。
要求它保留原本用詞與語序,只修正明確的辨識錯誤、移除沒有意義的贅詞,並改善標點。
這樣確實比較不容易發生大幅度改寫,但輸出的文字就是沒有 Typeless 那麼好讀。
後來我才意識到,問題可能出在最佳化目標本身。
我一直要求 LLM 盡量不要改寫,但 Typeless 最強的地方,恰恰是它非常懂得什麼時候該改寫。
人類說話本來就不會按照文章的結構進行。要把一段口述內容變成高品質文字,通常必須適度重新組織語句,而不是只做拼字和標點修正。
後來我把 Prompt 的方向改成「保留原始意圖,而不是保留原始措辭」,允許模型重組語序、合併碎句和改善段落,但是嚴格保護事實、立場、條件與語氣強度。
這個方向明顯更符合我的需求。
但即使如此,要讓輸出品質在各種情境下都維持穩定,還是需要相當多測試資料。
第四個坑:一整條 Pipeline 的品質,比單一模型重要
如果把一個 AI 語音輸入系統拆開來看,大致可以理解成以下流程:
Audio Capture → VAD → ASR → Context → LLM Polish → Fidelity Validation → Text Injection
其中任何一個階段都可能出錯。
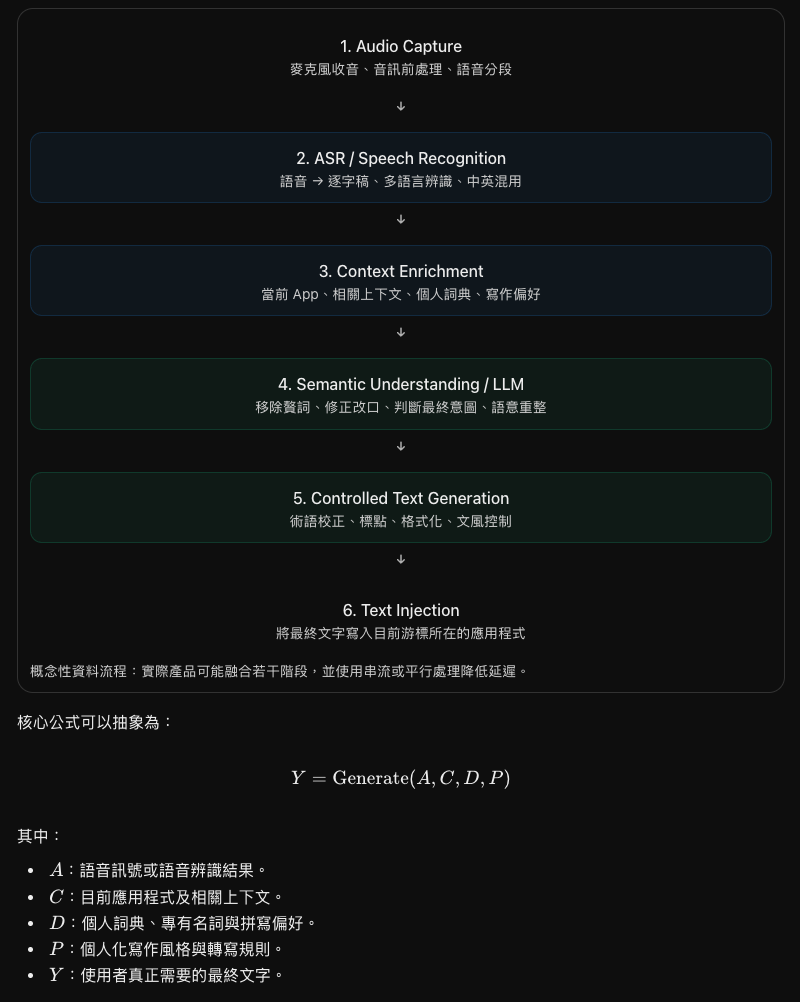
VAD 太敏感,可能把語音開頭切掉;分段太短,會遺失上下文;分段太長,又會增加等待時間。ASR 可能辨識錯誤,LLM 可能過度改寫,驗證器可能拒絕正確修正,最後 Text Injection 還可能因為輸入焦點改變而失敗。
更麻煩的是,這些錯誤不是彼此獨立的。
有些錯誤可以被後續階段修復,有些則會被放大。每一個階段的設計,都會影響其他階段的表現。
因此真正需要最佳化的,不是一個模型在 Benchmark 上的分數,而是整個系統的 End-to-End Quality。
我認為要做到接近 Typeless 的品質,需要蒐集大量涵蓋不同語音情境的測試資料,例如台灣口音、中英混用、專業術語、連續改口、口語贅詞、長時間口述,以及不同 App 的輸出格式需求。
更重要的是,評估標準不能只有辨識準確率,而應該包含語意保真、文字可讀性、端到端延遲,以及使用者實際需要修改多少內容。
這些都是工程問題,也都是產品品質的一部分。
五、Typeless 的護城河,究竟是模型還是產品工程?
研究完之後,我反而不認為 Typeless 的核心競爭力一定來自某個非常神奇、其他人拿不到的 ASR 模型。
現在的基礎模型進步太快了。Whisper、各種即時 ASR 模型,以及越來越便宜的 LLM API,都讓開發語音輸入工具的門檻大幅下降。
從功能上來看,開源方案已經能實現許多 Typeless 的能力。
例如 OpenTypeless,就已經具備 BYOK、LLM Polish、個人字典、不同 App 的風格設定,以及多種模型供應商的串接能力。
我甚至直接研究過它的 Prompt 原始碼。它同樣知道要處理 Filler Words、False Starts、自我修正、重複語句和文字格式。
也就是說,這些功能的基本原理並不是秘密。真正困難的是如何把每個細節調整到足夠成熟,而且在不同情境下都能維持一致的品質。
我認為 Typeless 至少有三個值得研究的競爭優勢。
- 首先是語意理解與文字重建能力。它不是簡單移除贅詞,而是盡可能整理人類說話時非線性的思考過程,同時保留真正想表達的內容。這種能力最難的地方,不是讓文字變漂亮,而是讓文字變漂亮之後,意思仍然正確。
- 其次是上下文與個人化。它有個人字典,也能根據使用情境調整語氣與文字風格。這種能力讓使用者不需要每次重新告訴模型自己的偏好,對高頻使用者尤其重要。
- 最後是完整的產品工程。從語音擷取、模型處理、低延遲回應,到跨 App 輸入、背景運作及跨裝置使用,每個環節都必須足夠可靠,才有辦法讓使用者真正建立使用習慣。
我不認為這代表開源產品永遠追不上 Typeless。事實上,很多開源專案迭代得非常快,未來也可能出現表現更好的方案。但至少在我目前實際比較過的工具裡,Typeless 整體的完成度仍然很高。
它的護城河不只是技術能力,而是把複雜的技術整合成一個使用者幾乎不需要思考的工作流程。而這種產品工程上的成熟度,本身就有價值。
六、macOS 的開源方案已經很多,但真正困難的是 iOS
這次研究還讓我發現一件事情:如果只看 macOS,現在其實已經有相當多值得使用的替代方案。
我自己用 MacWhisper 就可以處理不少語音轉錄需求,而像 OpenTypeless、Handy、VoiceInk,以及其他基於 Whisper 或開源 ASR 模型的工具,也提供了各種本地運算和 BYOK 的選擇。
如果你本身有工程能力,願意花時間設定 API、管理模型、調整 Prompt,我認為這些方案都值得研究。
但我的問題是,我真正需要的其實還包含 iPhone。
在電腦前,我本來就可以透過鍵盤快速輸入,必要時也能自己寫一些自動化腳本。但在手機上,情況完全不同。例如在外面突然想到一個產品方向、需要回覆比較長的訊息,或是想跟 AI 討論一個複雜問題時,我並不想在手機鍵盤上慢慢打字。
這時候,如果可以直接用語音表達,並且得到一段幾乎不需要修改的文字,生產力提升就非常明顯。
偏偏 iOS 的系統限制,讓這件事情沒有 macOS 那麼容易實作。
iOS 第三方鍵盤擴充功能不能直接像一般 App 一樣使用麥克風,因此開發者需要另外設計錄音流程、主 App 與鍵盤的資料交換、背景執行和使用者介面切換。
這些都是維護成本。
我在 UTUVO Type 的 PR 裡,也特別處理了本機與雲端模式、使用者授權、App Group 共享設定,以及不同輸入欄位之間的文字交付問題。
這讓我更能理解,為什麼桌面版的開源替代方案看起來很多,但真正能在 iPhone 上提供完整、穩定、低摩擦語音輸入體驗的選擇,相對少一些。
當然,台灣也有開發者正在解決這個問題,例如 SogaType、Shaberu、KIAO Voice 等產品,都值得繼續關注。
但對我來說,選擇 Typeless 的重要原因之一,就是我希望同一套語音輸入體驗能夠延伸到日常使用的不同裝置,而不需要自己持續維護多套工具。
七、既然 API 這麼便宜,為什麼 US$30 一個月還是有人買?
這裡其實涉及一個很有趣的產品定價問題。
從工程師的角度來看,現在的 STT 和 LLM API 成本已經不高。使用者如果願意自己維護 BYOK 的工作流程,處理相同語音量的模型成本確實可能遠低於 Typeless Pro 的月費。
Typeless Pro 目前月繳 US$30,年繳則相當於每月 US$12。對單純的語音轉文字功能來說,這個價格不便宜。
但是,如果改從使用者的時間成本來看,計算方式就不同了。
假設一個人每天用語音輸入二十次,每次如果都能少花三十秒修改文字,一個月以二十二個工作天計算,就能節省約 3.7 小時。
這還沒有計算上下文切換、重新閱讀與重新組織想法所產生的成本。
當然,這只是說明性的假設,不是 Typeless 實測可以節省的時間。但它凸顯了一個問題:如果一個工具真的能穩定消除人工修改,那麼訂閱費就不應該只拿來跟 API 的 Token 成本比較。
我還看到一篇 Threads 的討論,原 PO 提到 Typeless 免費版的字數額度,表示將從每週 8,000 字減少至 2,000 字,因此徵求其他替代方案。
那篇討論引出了非常多台灣開發者自製的產品,也有人分享自己測試多種開源工具之後,仍然認為 Typeless 的整體使用體驗比較好。
雖然已有使用者與第三方文章記錄 2026 年 9 月 22 日的額度縮減通知,但截稿時 Typeless 官方定價頁仍顯示每週 8,000 字,官方頁面與用戶通知並不一致,實際額度應以登入後的帳號顯示為準。
但我覺得這個討論反映出一個有趣的現象。
當你還沒習慣高品質語音輸入之前,會覺得它只是一個比較方便的打字工具。可是一旦習慣了用講話的方式,直接產生可以發送的文字,再回去使用傳統聽寫,差異就會非常明顯。
而且這種差異不只是速度。
它改變的是你願不願意隨時記錄想法、願不願意把一段複雜的問題完整表達出來,以及願不願意跟 AI 進行更長、更深入的互動。
對我來說,這些才是值得付費的地方。
我並不是認為所有人都應該訂閱 Typeless。如果只是偶爾語音輸入,或者主要目的是離線轉錄、隱私保護、自行掌握模型,開源方案可能更適合。
但如果你每天都需要大量溝通,而且希望輸出的文字直接可以使用,那麼選擇工具時,真正應該比較的是整體生產力,而不是單純的訂閱費或 API 成本。
八、我整理過的 30 多個語音輸入工具與開源專案
為了尋找替代方案,我不只研究了 Whisper 和幾個熱門 GitHub Repository,也花了不少時間看台灣開發者的分享、社群討論,以及各家產品的官方文件。
其中一個契機,是 2026 年 9 月台灣社群有人因為 Typeless 免費額度調整,開始徵求更便宜的語音輸入工具。我把相關留言裡提到的方案整理出來,又補充了其他社群討論和我自己找到的專案。
研究下來,我認為這些工具其實可以分成幾個不同方向:開源與 BYOK、台灣繁體中文優先、手機輸入法、跨平台商業服務,以及系統內建聽寫。
這裡先說明研究範圍:Typeless、MacWhisper、API 串接與 UTUVO Type 屬於我實際使用或動手開發過的範圍;OpenTypeless 則有進一步研究其原始碼。其餘部分是我透過官方網站、GitHub 和社群資料蒐集的替代方案,不代表每一款都已完成相同條件的實測。
這樣分類,比直接把所有工具放進同一張排行榜更有意義,因為它們要解決的問題不完全相同。
8.1 開源與 BYOK:想自己控制模型的人,可以先看這些
這類工具比較適合工程師,或是想要自己掌握 API 成本、模型選擇、資料流向的人。
| 工具 | 平台與定位 | 研究重點 |
|---|---|---|
| OpenTypeless | macOS/Windows/Linux | BYOK、LLM Polish、個人字典、App-aware Context,功能架構接近 Typeless |
| UTUVO Type | Mac/iOS/Android | 開源輸入法、本機優先、BYOK、語意保真;我實際提交過 PR |
| Handy | 桌面語音輸入 | 免費開源、本地模型與離線處理 |
| VoiceInk | macOS | 原生語音輸入、模型與字典設定 |
| Speakey | macOS | 免費開源,按住快捷鍵說話;社群推薦的中英及多語辨識方案 |
| VoiceType | 桌面語音輸入專案 | Ryan Chan 的語音輸入實作 |
| TypeGood | 桌面生產力工具 | 同一開發者的另一個專案 |
| VoiceFlow | 語音工作流程 | 社群提供的開源研究入口 |
| VoiceInk(tienenwu) | 語音輸入專案 | 另一個同名專案,需與 Beingpax 的 VoiceInk 區分 |
| TalkClip | 語音工具 | 語音輸入與剪貼簿工作流程 |
| Purri | 桌面工具 | 社群分享的語音輸入方案 |
| Typeness | 語音輸入工具 | 台灣開發者專案 |
| QwenASRMiniTool | ASR 模型工具 | 研究 Qwen3-ASR 與本地辨識 |
| VibeVoice | 語音模型研究 | Microsoft 開源語音模型,並非完整的 Typeless 替代 App |
這裡我最推薦想自己開發的人研究 OpenTypeless,因為它不只有語音辨識,還包括文字潤飾、上下文與輸入整合,可以直接看到完整的產品架構。
但也要注意,免費、開源、本地運算和 BYOK 是不同概念。開源程式不代表一定離線,也不代表不會把語音送到第三方 API。
如果你的需求只是快速語音轉文字,Handy 或本地 Whisper 方案可能就足夠;如果想研究如何把口語變成可直接使用的文字,則應該特別關注 OpenTypeless 的 Pipeline 和 Prompt 設計。
8.2 台灣團隊與繁體中文優先的產品
這一類工具是這次研究中很值得注意的部分。
語音辨識模型即使支援繁體中文,也不代表輸出一定符合台灣日常用語。中英夾雜、專有名詞、中文標點、台灣慣用詞和注音輸入法整合,都可能形成產品差異。
| 工具 | 平台 | 特色與研究方向 |
|---|---|---|
| SogaType | iOS/iPadOS/Mac,另有其他平台產品資訊 | 台灣團隊、約 22 萬條台灣詞庫、注音鍵盤、AI 修正與翻譯 |
| Shaberu | Mac/iPhone TestFlight | 台灣用語、中英夾雜、詞彙表與語意潤稿 |
| KIAO Voice | macOS/Windows/iOS/Android | 台灣用語、語音輸入、逐字稿與會議記錄 |
| MomoSoft | 桌面輸入工具 | 台灣獨立開發者的語音輸入產品 |
| KOKIBOARD | iPhone | 注音鍵盤、麥克風輸入、AI 草稿、客服回覆及台灣法規敏感用語提示 |
| Talkiie | 社群推薦 Mac 方案 | 開發者宣稱偏向免費、本機處理;仍需獨立驗證詳細功能與維護狀態 |
- SogaType 是這裡很有代表性的例子。它不只是做語音辨識,也把台灣詞庫、注音鍵盤和 AI 文字整理放在同一個產品裡。官方 App Store 頁面目前顯示約 22 萬條台灣詞庫,並提供手機端語音辨識及雲端文字修正。不同平台的版本和訂閱條件可能不同。
- Shaberu 也值得關注。它明確針對台灣的中英夾雜和語言習慣設計,而且把詞彙表提供給辨識流程,而不只是事後替換文字。它的 iPhone 版本目前以 TestFlight 形式提供測試。
- KIAO Voice 則不只做語音輸入,還整合了錄音檔轉錄、字幕和會議記錄,因此如果需求涵蓋訪談、Podcast 或會議整理,值得一起比較。
- KOKIBOARD 的定位比較不同。它不是單純要取代 Typeless,而是把語音、注音輸入、AI 草稿、客服知識庫和台灣法規用語檢查放進同一個鍵盤裡。這反而讓我想到,未來的 AI 輸入法可能逐漸變成更貼近特定產業的工作介面,而不只是通用語音辨識。
另外,社群還提到一個名為 Brainless 的開發者作品,但目前沒有可直接驗證的公開下載連結,必須聯絡作者取得,因此我不把它列為已確認可公開下載的替代方案。
8.3 跨平台、BYOK 與商業語音輸入產品
如果把比較範圍擴大到國際市場,其實 Typeless 還有不少值得研究的競爭者。
其中有些產品的商業模式和 Typeless 類似,提供訂閱制的語音輸入服務;也有些產品採取 BYOK、一次性授權或本地運算,試圖降低使用者的長期成本。
| 工具 | 平台 | 特色與定位 |
|---|---|---|
| use.fo | macOS/Windows/iOS/Android | BYOK、一次性授權、桌面本地 AI、可選訂閱制 |
| Wispr Flow | macOS/Windows/iOS/Android | AI 語音輸入、語意整理、跨 App 整合 |
| Superwhisper | macOS/Windows/iOS/Android | 多模型、語音轉文字、AI Modes 與工作流程 |
| MacWhisper | Mac,另有 iOS 產品 | Whisper 轉錄、音檔處理與語音工具 |
| Willow | AI 語音輸入產品 | 社群推薦的 Typeless 類工具 |
| SumiVoice | AI 語音輸入產品 | 社群分享的替代方案 |
| OmuType | Android/Mac,iPhone 版開發中 | 香港繁體、粵語語音輸入、中英混打、倉頡/速成/粵拼 |
| 聲筆 wa gong | iOS 社群推薦工具 | 自有 API Key 與手機語音輸入方向 |
這裡我覺得最值得特別比較的,其實是 use.fo、Wispr Flow 和 Superwhisper。
- use.fo 的策略非常接近工程師想要的 BYOK 模式。 官方提供 macOS、Windows、iOS 和 Android 支援,讓使用者自行指定 API Provider;另外在支援的桌面裝置上,也可以選擇本地 AI。它不是完全免費,BYOK 和本地模式仍需要購買授權,但使用者可以避免被綁定在固定的雲端訂閱方案,模型 API 費用則另外計算。
- Wispr Flow 和 Superwhisper 更適合拿來比較完整產品體驗。前者強調在各種 App 中直接口述、消除贅詞並輸出整理好的文字;後者則提供多種模型與工作模式,適合想要在辨識、文字處理和自訂工作流程之間取得彈性的使用者。
這些工具都不應該直接被稱為「開源替代方案」,因為它們的產品授權和模型控制方式不同。但從競爭產品的角度來看,它們都是 Typeless 值得認真比較的對象。
OmuType 則是一個很有趣的區域化案例。它主要為香港使用者設計,強調粵語、香港繁體中文與中英混打,現在除了 Android 也有 Mac 版本。這種高度在地化的輸入法設計,未必適合所有台灣使用者,卻證明了同樣是繁體中文市場,不同語言與輸入習慣仍有非常大的差異。
8.4 完全免費或不需要額外安裝的方案
最後也不能忽略系統內建工具。
| 工具 | 適合情境 |
|---|---|
| Apple macOS 內建聽寫 | 簡單輸入、短訊息,不想安裝額外工具 |
| Apple iOS 內建聽寫 | 手機上最直接的免費語音輸入 |
Windows Win + H | Windows 內建語音輸入 |
| 本地 Whisper / whisper.cpp / faster-whisper | 有工程能力、想自行部署並控制音訊資料 |
| Gemini App 等 AI App 的語音功能 | 主要是跟 AI 對話,不一定需要跨 App 文字輸入 |
這些方案的優點是使用門檻相對低,或是可以自行控制模型與成本。但它們未必都能像 Typeless 一樣,在目前游標位置直接輸出經過深度整理、符合情境的文字。
8.5 研究完這些工具,我反而更確定應該怎麼比較
我不認為任何一份產品清單可以直接回答哪一款最好。因為每個人的使用情境不同,優先順序也不同。
如果只是把語音轉成文字,傳統 STT 就有很多解決方案。如果想降低 API 成本,可以研究 BYOK;如果重視資料不離開裝置,可以選本地模型;如果經常使用台灣繁體中文和專有名詞,就需要關注在地化詞庫與字典設計。
但如果像我一樣,希望在 Mac 和 iPhone 上,把一段沒有刻意整理過的口述,直接轉成能夠發送的工作訊息,那麼評估標準就完全不同。
我最在乎的不是它背後用了什麼模型,而是文字最後需不需要修改。
所以,如果真的要做嚴謹的 A/B Test,我會使用相同的一批語音測試資料,測量幾個指標:辨識錯誤率、專有名詞正確率、語意保真、可讀性、處理延遲,以及最後的人工修改時間。
特別是最後一個指標,才真正對應到生產力。
這份清單也讓我更確定,Typeless 不是沒有競爭者。相反地,這個市場已經有大量不同定位的產品,而且還有很多台灣開發者正在持續投入。
只是目前在我的使用情境下,Typeless 仍然提供了最符合需求的整體體驗。
結論:最好的輸入法,是讓輸入這件事情逐漸消失
從早年研究注音輸入法、拼音輸入法的效率,到後來使用語音輸入,再到現在研究 AI 語音辨識與 LLM,我其實一直在追求同一件事。
我希望電腦能夠更快理解我的想法,而不是要求我不斷適應電腦的輸入方式。
以前我們在意打字速度、選字效率、候選詞排序,因為人類必須把每個字輸入進去;後來有了語音辨識,我們不需要再透過鍵盤輸入每個字,但仍然需要自己整理語句、修正錯誤;現在 LLM 的出現,讓輸入法開始有能力理解語意、整理思考過程,甚至直接產生可以使用的文字。
如果未來的 AI 能夠更準確地理解上下文、個人偏好與溝通目的,那麼我們或許根本不需要再把「輸入」視為一件獨立的工作。
你只需要專注在自己想表達什麼,至於應該怎麼把它變成文字,交給系統處理就好。
對一個需要大量溝通的創業者來說,我認為這是一個非常有價值的方向。因為真正重要的從來不是每分鐘打了多少字,而是我們能不能更快、更精確地傳遞想法,讓事情往前推進。
這次為了找更便宜的替代方案,我研究了很多工具,自己調整模型與 Prompt,也實際參與了 UTUVO Type 的開發。過程中確實學到了不少東西,但最後也讓我更能理解,一個看起來簡單的產品,要把各個細節做到成熟,需要投入多少工程與測試成本。
所以最後,我還是付費買了 Typeless。
不是因為開源方案做不到,也不是因為我不想再研究,而是我發現,在目前的工作流程裡,Typeless 能更穩定地提供我真正需要的結果。
我花時間研究輸入法,是為了減少花在輸入上的時間。如果為了節省訂閱費,反而需要持續投入更多時間維護輸入法,那就有點本末倒置了。
這也是我這次研究完最有感觸的事情。
對我來說,生產力工具最終的目標不是讓我們做更多操作,而是讓那些不必要的操作消失。
最後,分享給同樣喜歡自己研究工具的人
這篇文章是我研究、比較、測試,甚至自己參與開源專案開發之後,自發性寫下的心得,並不是 Typeless 的邀約業配。
原本我就是想找一個更便宜、可以自己控制模型的替代方案,才花這麼多時間研究。如果有興趣,也可以直接去看我在 GitHub 提交並已合併的 UTUVO Type PR #1,裡面記錄了不少我實際碰到的技術問題,以及如何改善 iOS 的 BYOK 語音輸入流程。
我想把這些研究過程公開,分享給那些跟我一樣喜歡自己動手做、想要架設 BYOK 方案,或是正在尋找開源替代工具的人。至少可以讓大家少走一些我已經踩過的坑,也許能省下不少測試時間。
如果你還沒有使用過 Typeless,我建議可以先試用免費版本,不需要一開始就付費。也可以透過我的 Referral 推薦連結 註冊,推薦碼是 QXG3WKV。
透過推薦連結註冊不需要先購買任何訂閱。依照 Typeless 官方推薦計畫,符合資格的新用戶可取得 US$5 Typeless Pro 抵用金;當被推薦者完成 2,000 字口述後,我也會獲得相應的 Pro 抵用金。這是訂閱抵用金,不是現金,而且適用條件以官方規則為準。
另外還有一個很多人可能不知道的資訊:Typeless 有學生優惠,符合資格的學生可以享有 Pro 原價 5 折。 可以到 Typeless 學生優惠頁面 使用學校 Email 驗證資格。這項優惠目前僅適用於桌面版結帳,而且官方說明是提供給尚未訂閱 Pro 的用戶。
如果你已經體驗過,覺得 Typeless 確實適合自己的工作流程,決定要購買 Pro,也可以使用我的 Typeless Affiliate 聯盟推廣連結。透過這個連結完成符合資格的付費訂閱,我可能獲得訂閱佣金,也算是支持我持續研究、測試並分享這些工具。
這兩種連結是不同的計畫,不能預設 Referral 抵用金、學生優惠與 Affiliate 佣金可以全部疊加。相關獎勵與佣金也以桌面結帳為主,不適用於 App Store 或 Google Play 內購。
不論你最後選擇 Typeless,還是自己建立一套開源或 BYOK 的語音輸入系統,我都覺得值得嘗試。因為我相信,隨著 LLM 持續進步,AI 輸入法會逐漸成為人類與電腦互動的重要介面。
而我們真正應該追求的,不是更快地打字,而是讓想法與行動之間的距離越來越短。
本文更新於 2026 年 11 月 1 日。工具功能、免費額度、平台支援與訂閱價格可能隨版本調整,請以官方資訊為準。本文包含 Referral 與 Affiliate 連結,相關利益關係已於文中揭露。